読み込み中...

bash homepage
bash のプロフィール・ブログ・podcast を配信する個人サイト
通知を受け取るには、ホーム画面に追加してから購読してください。

このホームページにWebmentionを実装しました 未読
このホームページにWebmentionを実装しました
このホームページに、Webmentionを実装しました。 きっかけ そもそもこのホームページを作ったのは、まじめにソーシャル・ネットワーキングをやりなおす2026という記事を読んだのがきっかけでした。 あらためて自分の手で、ぼくの書いたもの・話したことを受け取ってくれる人たちとの関係を、結び直していきたいと思います。 これを自分なりのかたちでやってみたくなったのです。 そして2026-09-25の記事でWebmentionを知り、先日このホームページにも組み込みました。 Webmentionとは 記事にリンクを書いたとき、リンク先のサイトに「あなたの記事にリンクしました」と知らせる仕組みです。知らせる側が、リンク先のページから受け口のURLを探して、source(自分の記事)とtarget(リンク先)をPOSTします。 送る 記事の公開(deploy)の最後のステップで、CRubyで送っています。 公開した記事の本文から、よそのサイトへのリンクを拾う リンク先から受け口を探す(HTTPのLinkヘッダ、HTMLの) 受け口へsourceとtargetをPOSTする 送った組はD1に記録していて、次のdeployで同じところへ送り直すことはありません。受け口が無いリンク先も記録して、探し直しません。 受ける 受け口はCloudflare Workersの上のPicoRubyで動いています。ページのとLinkヘッダで、受け口の場所を知らせています。 呼ばれるのは、どこかのサイトがこのホームページの記事にリンクを書いて、そのサイトの送信処理が受け口を探して送ってきたときです。 受けたら、送り元のページを取りに行って、本当にこちらの記事へのリンクがあるかを確かめてから、D1に入れます。 いまのところ いただいたWebmentionは、自分用の管理画面で拝見させてもらうようにしています。
サポーターズCoLab #spzcolab 10/29開催 AI活用 LT祭り ─ あの人・あの会社のAI活用事例 イベントに登壇します 未読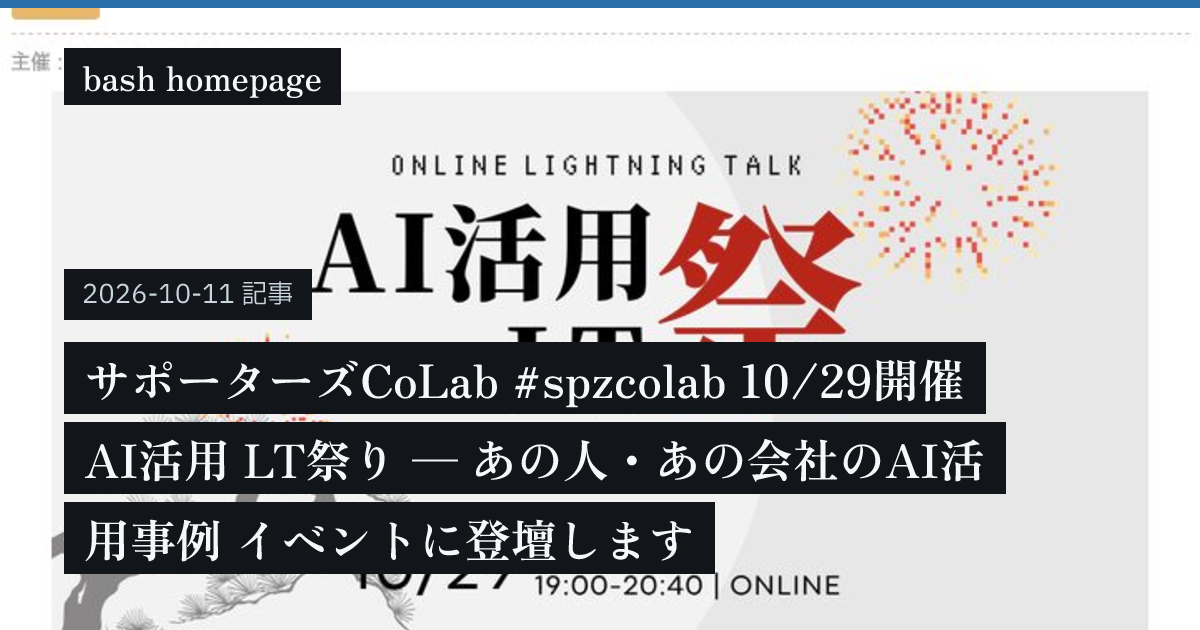
サポーターズCoLab #spzcolab 10/29開催 AI活用 LT祭り ─ あの人・あの会社のAI活用事例 イベントに登壇します
https://supporterz-seminar.connpass.com/event/406206/ 全社を挙げたエンジニア職のビッグイベント「技術力評価」運営をAI技術で切り回す裏方秘伝のテクニック というタイトルでお話します。 こういう運営の仕事は結構やってきました。今もその件以外にも公私ともに複数やっています。不定形業務の塊なんですが、そこにどのように切り回しをやってるかの技術について、ご紹介できればと思います。 ぜひご登録ください!
mrubyのバイトコードをネイティブ実行するCPUをFPGAで作っていてLチカまできた 未読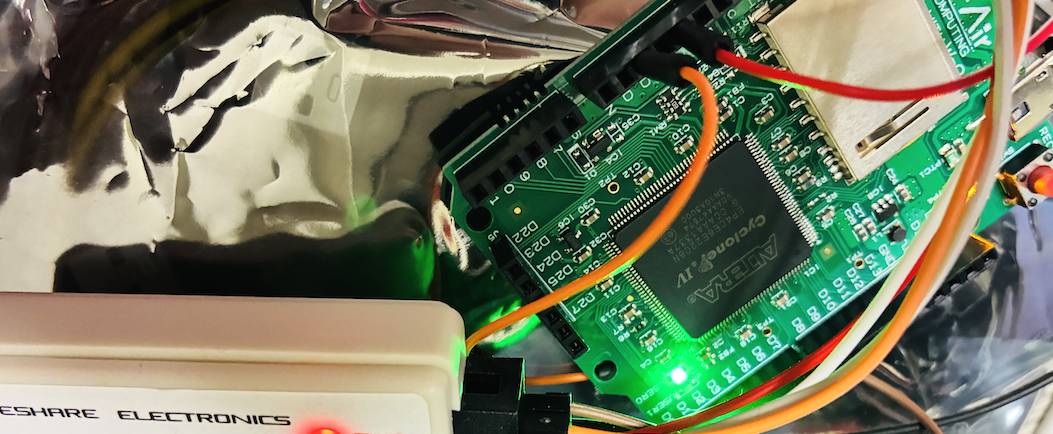
mrubyのバイトコードをネイティブ実行するCPUをFPGAで作っていてLチカまできた
FPGAの上に、mrubyのバイトコード(.mrb)を機械語としてそのまま実行するCPUをつくっています。そのCPUが、実機でLEDを点滅させました。 目指しているのは、R2P2と同じ使い心地の、mrubyネイティブのマイコンボードです。電源を入れるとshellが上がり、mrubyソースコードでピンを操る、というものです。 R2P2-dev-harnessのPR #24で進めています。 手探りもいいところで理解自体も機能もこれからではありますが、まずは一区切りとして記事にしています。 つかったもの PERIDOT-Air(Cyclone IV E EP4CE6E22C8N、6,272 LE) USB-Blaster互換のダウンロードケーブルと、ジャンパー線6本 Quartus Prime Lite 23.1std.1(Apple containerのx86-64 Ubuntu 22.04とRosetta) openFPGALoader 1.1.1 Verilator 5.052 PicoRubyのmrbc、mrubyのmrblib、picoruby-gpio MacBook Pro(M1 Max) Claude Code いまの状態 Lチカ1本ぶんの範囲が、実機で動いています。 led = GPIO.new(28, GPIO::OUT) loop do led.write(1) sleep_ms 500 led.write(0) sleep_ms 500 end PicoRubyのLチカそのままです。GPIOのピン28を、板のUSER_LED0に割り当てています。 hostのmrbcにかけると、217バイトの.mrbになります。中身はirepが2つです。 irep 0 (トップレベル) 000 GETCONST R2 GPIO 003 LOADI8 R3 28 006 GETCONST R4 GPIO 009 GETMCNST R4 (R4)::OUT 012 SEND R2 :new n=2 016 MOVE R1 R2 ; R1:led 019 BLOCK R3 I[0] 022 SSENDB R2 :loop n=0 026 RETURN R2 028 STOP irep 1 (loopに渡すブロック) 000 ENTER 0:0:0:0:0:0:0:0 004 GETUPVAR R2 1 0 008 LOADI_1 R3 (1) 010 SEND R2 :write n=1 014 LOADI16 R3 500 018 SSEND R2 :sleep_ms n=1 022 GETUPVAR R2 1 0 026 LOADI_0 R3 (0) 028 SEND R2 :write n=1 032 LOADI16 R3 500 036 SSEND R2 :sleep_ms n=1 040 RETURN R2 CPUはこの命令の並びをROMから読んで、そのまま実行します。 ROMに入れたもの mrubyソースコード 出どころ .mrbの大きさ blink.rb 自分で書いたもの 217バイト kernel.rb mrubyのmrblib 599バイト gpio.rb picoruby-gpioのmrblib 2,663バイト kernel.rbとgpio.rbには手を入れていません。 loopは、kernel.rbにあるKernel#loopの定義をCPUが起動のときに実行して、メソッドとして登録したものです。GPIO.new(28, GPIO::OUT)は、gpio.rbのinitializeからsetmode、set_dirへと、バイトコードのまま辿ります。 シミュレーションで合わせる 実機の前に、Verilatorで回路を走らせて、ピンの変化の列を取りました。 同じblink.rbをhostのPicoRubyでも走らせて、2,000msまでの6回の変化が、同じ時刻と同じ値になることを確かめています。 FPGAに書き込む 書いた回路をFPGAに書き込めるデータへ変換する作業を、合成といいます。PERIDOT-AirのFPGAでは、メーカーのAlteraが配っているQuartus Prime Liteというソフトで合成します。 QuartusはWindows用とLinux用が配られていて、Mac用はありません。 わたしの手元はMacBook Pro(M1 Max)なので、Macの中でLinuxを動かし、その中でQuartusを動かしました。 Macの中でLinuxを動かすのには、Appleが出しているcontainerというツールを使っています。QuartusはIntel系のCPU向けのソフトで、M1 MaxはCPUの種類が違うので、Rosettaを通しています。 項目 値 ロジックエレメント 4,792 / 6,272(76%) レジスタ 1,959 メモリ 49,088 bit 50MHzのsetup slack 3.539 ns yosysでの事前の見積もりは3,994 LEでした。Quartusの結果は、それより798 LE多く出ました。 JTAGがつながらない USB-Blaster互換のケーブルを、同梱のJTAG-CONN変換基板と10ピンのリボンケーブルでつなぐと、openFPGALoader --detectが返すIDCODEが全部0でした。Macを替えても同じでした。 切り分けは2段でやりました。 まず、USB-Blasterの10ピンの口でTDOとTDIをジャンパー線でつなぎ、0以外が読み戻せることを見ました。USB-Blasterの口は生きています。 次に、変換基板とリボンケーブルを通さずに、USB-Blasterから板へジャンパー線6本で直結しました。 USB-Blasterの10ピン PERIDOT-Air 3番 TDO ─────────── JTAGの6ピンの1番 TDO 1番 TCK ─────────── JTAGの6ピンの3番 TCK 5番 TMS ─────────── JTAGの6ピンの5番 TMS 9番 TDI ─────────── JTAGの6ピンの4番 TDI 4番 VCC ─────────── 電源のピンソケットの3.3V 2番 GND ─────────── 電源のピンソケットのGND これで応答を得ることができました。変換基板なのかリボンケーブルなのか、挿し方の問題かは切り分けできていません。 点滅 rake fpga:flashで書き込むと、USER_LED0が0.5秒ごとに点いたり消えたりしました。 参考にしたもの osafune/peridot_airの回路図とピン配置図 picoruby/picoruby mruby/mruby trabucayre/openFPGALoader
PicoRubyのCloudflare Workers対応を使い始めました 未読
PicoRubyのCloudflare Workers対応を使い始めました
このホームページの管理画面のバックエンドを、Cloudflare Workersの上のSinatraで動かしています。udzura/picoruby-cloudflare-worker-wasmとudzura/picoruby-sinatra-coversを使っていて、udzuraさんのSinatra on Cloudflareの「今」と「これから」をもとに対応していきました。引き続きudzuraさんプロダクトのお世話になっております。 かねてはローカルで管理画面を動かしていたのですが、出先やスマホから使いたかったのでクラウド側に移し、また記事作成はGitHubのissueとラベルとActionsでできるようにしました。
個人用エージェント基盤のローカルLLMをllama.cppベースで動かすようにした 未読
個人用エージェント基盤のローカルLLMをllama.cppベースで動かすようにした
個人用エージェント基盤のローカルLLMを、llama.cppのllama-serverベースで動かすようにしました。この仕組みを「llamama」と呼んでいます。 モデルはQwen3.6-35B-A3Bです。MacBook Pro(M1 Max、メモリ64GB)を推論サーバー、MacBook Air(M3、メモリ24GB)を手元のフォールバックにして、2台で動かしています。 回している仕事 esa記事を毎日要約するパイプラインの推論このllamamaにしました。 一発質問・分類・要約のような、エージェントループを使わない単発のリクエストが、llamamaで安定して回っています。コードや記事の中身が手元のMacの中で完結する経路が1本できたことが、いちばんの価値です。 速度 llama-benchで以下の条件で測っています。 MacBook Pro(M1 Max 64GB)電源モード「自動」 MacBook Pro(M1 Max 64GB)電源モード「省電力」 MacBook Air(M3 24GB) モデルの量子化 Q4_K_XL(22.36GB) Q4_K_XL(22.36GB) IQ2_M(11.5GB) コンテキスト長 64K 64K 32K 生成速度(空コンテキスト) 60.5 tok/s 42.5 tok/s 約30 tok/s 生成速度(32K深さ) 45.7 tok/s 未計測 約11 tok/s prefill速度(空コンテキスト) 912.5 tok/s 未計測 未計測 prefill速度(32K深さ) 441.3 tok/s 未計測 未計測 コード生成のリードタイム MacBook Airで、fib.rbを作ってテストして実行するタスクをOpenCodeに任せました。成功して、所要は約4分です。生成は約25 tok/sあるので、時間の大半はQwen3.6のthinkingでした。 推論サーバーの切り替え対応 作業ディレクトリでocと打つと、OpenCodeが起動します。推論サーバーは、起動のたびに自動で選ばれます。 oc MacBook Proが起きていればMacBook Pro、寝ていればMacBook Airのローカル OC_MODE=local oc MacBook Airのローカル固定(出先) OC_MODE=remote oc MacBook Pro固定 選択用のCLIが、各推論サーバーの/health(timeout 2秒)を見て決めます。推論サーバーは設定ファイルに優先順で書いていて、上から最初に応答したものが使われます。MacBook Airのローカルが選ばれたときに停止中であれば、起動してから接続します。 MacBook Airのローカルは、無操作が10分続くとモデルをメモリから外します(RSS 11GBから0.1GB)。次のリクエストで約2秒で戻ります。 メニューバーに常駐するmacOSアプリに、今どの推論サーバーが選ばれているかが出ます。メニューには「接続先: 自動(MBP優先)」「接続先: MBP固定(remote)」「接続先: このMac固定(local)」の3択があり、選んでいる項目にチェックが付きます。選択は~/.config/llm/pick_modeに保存されて、次のocから効きます。 優先順位は、次のとおりです。 OC_MODE環境変数、または--mode引数 メニューの接続先選択 自動(何も選んでいないときの既定) MacBook Airのローカルの起動・停止も、このメニューから操作できます。
セルフホスティングのSinatra on PicoRubyを実験的に手元で動かしている 未読
セルフホスティングのSinatra on PicoRubyを実験的に手元で動かしている
このホームページの管理画面のバックエンドを、udzura/picoruby-sinatra-covers(PicoRuby上のSinatra)をもとに、自前ホストする形にして、実験的に手元で動かしています。udzuraさんプロダクトに頼りまくっています。いつもありがとうございます。 sinatra-coversはセルフホストするサーバーは今は未対応とのことで、セルフホスト対応のためのpicoruby-sinatra-self-hosted-serverという仕組みを用意しています。 picoruby-sinatra-self-hosted-serverの構成 udzura/picoruby-sinatra-covers への依存とともに、以下を組み合わせています。 picobrick: 開発用のHTTPサーバー。WEBrickインスパイア。 picoruby-rackup: https://github.com/udzura/mruby-rack と組み合わせて使って、picobrickはここへRackup::Handler::Picobrickを登録します picoruby-securerandom: Sinatraがロード中にSecureRandom.hex(64)を呼ぶための対応です ハックで回避していること upstreamへのご相談ご提案までは進められず、以下のような回避をしています。 PicoRubyのPOSIX/hostビルドとpicoruby-sinatra-coversとで、superclass違いの LoadError 定義がでてて、TypeError: superclass mismatchが発生します。 そこで、Object.send(:remove_const, :LoadError) if Object.const_defined?(:LoadError)だけの一行gem(picoruby-loaderror-reset)を作り、mrbgemの依存順でpicoruby-sinatra-coversの直後・picoruby-requireの直前に差し込むという小技を入れています。
PicoRubyでマルチコアを活用するpicoruby-multicoreというライブラリをつくっている 未読
PicoRubyでマルチコアを活用するpicoruby-multicoreというライブラリをつくっている
https://github.com/bash0C7/picoruby-multicore PicoRuby で動かす楽器や装置を作っていると、重い計算を挟みたくなる場面が出てきます。 たとえば音を作る途中で少し重いループを回したい、といったケースです。ところが PicoRuby の Task は協調的なマルチタスクなので、ひとつの Task が計算に専念している 間は同じコア上の他の Task が止まってしまいます。ESP32 や RP2350 (Pico 2 W) のような マイコンは物理的に複数のコアを持っているので、この重い計算だけをもう片方のコアに 逃がせないか、と考えたのが picoruby-multicore のきっかけです。 Task との使い分け Task と Multicore は競合するものではなく、役割が違います。 Task: 同じコアの中で、I/O 待ちやイベント待ちの間に他の処理へ切り替える協調的な マルチタスク。ボードの入出力やタイミング制御はこちらの領分です Multicore: 計算そのものを、もう片方の物理コアへ丸ごと渡してしまう仕組み。呼び出した 側の Task はブロックされず、他の Task は普段どおり動き続けます つまり、ボードの全体の制御や入出力は Task で組み立てつつ、その中で「これは重いので 待たされたくない」という計算だけを Multicore.run に投げる、という組み合わせで使います。 ワークフロー picoruby-multicore で一番こだわったのは、別コアで動くコードも Ruby だけで書けることです。 別コアにやらせる計算のことを、picoruby-multicore は kernel と呼びます (GPU プログラミング などで使われるのと同じ呼び方です)。裏では次の 3 つの道具が働きます。 spinel: 型付きの Ruby を native code に変換する AOT コンパイラ suppify: spinel の出力を、そのまま PicoRuby の mrbgem として組み込める形にするラッパー picoruby-multicore: 呼び出し引数と戻り値の byte 列への変換 (MessagePack)、コア間の 受け渡し、失敗時の状態コードを例外に変換する Ruby API (Multicore.run / spawn / open) 自分の firmware に組み込むところまで、順番に追ってみます。前提として、対象の board 向けの firmware build (build_config) がすでにあること、spinel を ビルド済みで SPINEL_LIB (または SPINEL / PATH) から見つかることが要ります (spinel 自身の README 参照)。 1. kernel を書く 別コアにやらせたい計算を、型付きの普通の Ruby ファイルとして書きます。型は RBS で 書きます (def の上にインラインで書くか、同名の .rbs を横に置くか)。 # lcg.rb # LCG (線形合同法) を n 回まわした値。重い job の見本 (n を大きくすると数秒かかる)。 #: (Integer) -> Integer def lcg(n) seed = 1 i = 0 while i 40222 # 待たずに投げておいて、あとで結果を受け取ることもできます job = Multicore.spawn(:lcg, 20_000_000) # ここで他の処理を続けられます job.value 引数や戻り値は Integer、Float、String、Symbol、nil、true / false、それらを入れ子にした Array や Hash まで、普通の Ruby の値としてそのまま渡せます。byte 列への変換もコア間の 受け渡しも、呼び出す側からは完全に隠れています。失敗した場合も状態コードではなく Multicore::TypeError や Multicore::RangeError のような例外になります。 今の状態 ESP32 (M5Stack Chain DualKey) では実機で動作確認できています。 RP2350 (Pico 2 W) は現在調査中で、まだ実機での確認は取れていません。 picoruby-multicore は GitHub で公開しています。 https://github.com/bash0C7/picoruby-multicore
このホームページのバックエンドをudzura/picoruby-cloudflare-worker-wasmに変更した 未読
このホームページのバックエンドをudzura/picoruby-cloudflare-worker-wasmに変更した
このホームページのバックエンドをmrubyedge/uzumibi + mrubyedge/mrubyedge から udzura/picoruby-cloudflare-worker-wasm へと切り替えました。引き続きudzuraさんプロダクトのお世話になっております。 ブラウザ側では以前からPicoRuby(のWebAssembly)が動いていたため、エッジ側もPicoRubyに揃えることで、一貫性があがるということと、Cloudflareの各種機能対応が現状でさらに揃っているポイントからでした。 移行ポイント 小さいホームページアプリケーションでほとんどツッからなかったのですが、記事データのパース速度だけ問題になりました。 以前のuzumibi(mrubyedge)版では、JSONのパース処理をRubyの外側(Rust層)で高速に行っていたため、約16msと1フレームで処理できていました。 しかし、PicoRubyに切り替えると、20KB程度の日本語記事のパースに1.1秒かかりました。 この大きな要因は、UTF-8マルチバイトによる O(n^2) の発生で、PicoRubyのUTF-8モードでは、マルチバイト文字を含む文字列の「i 文字目」を取得するたびに先頭からバイトを走査し直すため、O(n) のコストがかかります。これを n 文字分繰り返すことで、全体の計算量が O(n^2)になるということです。 施したこと そこで、PicoRubyにそもそもJSONを直接パースさせないための細工を施しました。 それは、独自トークン形式(.tok)への事前変換で、ビルド時(CRuby)に、JSONの代わりに区切り文字でつないだ平坦なトークン列(.tok)を出力しておき、PicoRuby側では String#split で一気に配列化し、再帰的にデコードするということです。 この細工により、4msに落とし込むことができました。
2026-09-21 23:10 未読
2026-09-21 23:10
9月に誕生日を迎えてまたひとつ歳を重ねたわけですが、ふと「この先、自分に残されている時間」について、これまでになくリアルに考えるようになりました。 そうした時間の有限性に意識が向いたのには、今年経験した大きな環境の変化も関係しています。約13年ぶりとなる転職という、自分にとってはとてもとても大きなチャレンジとなる決断をして、幸いにも試用期間を無事に乗り越えることができました。本当に続けることができるのかは内心不安だらけで、とはいえここからが本当の勝負というところですが、とはいえ区切りは区切り。生活の激変と張り詰めていた緊張が一段落したタイミングだったのです。 もともと、自分の中に強烈な「Will(やりたいこと)」がないこと自体には薄々自覚的でした。けれど、大きな山をひとつ越え、ふっと肩の力が抜けたシルバーウィーク。静かに自分の内側を覗き込んでみて確信しました。 やっぱり薄いのです。いや、薄いというより、本当に「ない」に近いのだと気づきました。 仕事のWillは「何をなすべきか」の中にだけある キャリア論でよく使われる「Will-Can-Must(やりたいこと・できること・やるべきこと)」というフレームワークがあります。 今の自分に引きつけて考えると、「Will」単体の熱量は非常に淡いものです。例えば「何々技術やりたい」「何々サービスやりたい」「何々ポジションを得たい」といったことは今は心の中に見当たりません あえて言うなら、いまの自分のWillは組織や事業貢献を目指すことを前提として、どのような変化を求められているか、自分からどのように変化を作っていけるかという、MustやCanの延長線上にあります。そういうことについて、挑んでいくわけです。 ですが、視点を「仕事」から「人生全体」に広げてみると、少し話が変わってきます。 人生のMustやCanとは 過去のあれこれを脇に置いて、「これからの人生で何になりたいか、何をしたいか」を自問してみました。 出てくる答えは、あまりにもミニマルなものでした。 日々の食事を丁寧につくる ウェイトトレーニングして身体を整える コードを書く 本を読む 散歩する たまにテックコミュニティの勉強会や交流に顔を出す これはこれで楽しいし、価値はあるし、大事とも思います。 でも「Will」かというと、人生体験としてさすがにまだできることが、やることがあるんじゃないだろうか。 そんな折に出会ったのが、「バケットリスト(死ぬまでにやりたいことリスト)」でした。 このやりたいことというのが難しくて、「そもそも自分は何にワクワクするのか」を沸き立たせる力は、すっかり錆びついていたようでした。 「どこかにマイル」「どこかにビューーン!」で、行き先を決めずにふらっと旅をする 筋肉量を増やす、挙上重量を増やす 体脂肪率を落とす 博物館にたびたび足を運ぶ 未知の技術を学びにいく パッと上がったのはこれぐらい。仕事では問題定義と解決の検討はけっこう着想を得られるのに、自分のこととなったらこの有様というのは今の現実。これをいかにやっていくかだけでなく、どのようにリストを育てていくかということそのものもリストインした方がいいかもしれません。